

total_amount da nota com duas moedas vale para toda execução daquele Caso de Teste, em toda versão, e para nada mais.
Onde as validações ficam
Abra um Caso de Teste, passe o mouse sobre um atributo e clique em Validações. O selo no botão conta os exemplos e as regras daquele atributo. O popover tem duas abas:- Regras: as regras em linguagem natural deste atributo, numeradas. Digite uma regra na caixa (Adicionar regra…) e clique em Adicionar ou pressione Enter. Passe o mouse sobre uma regra para excluí-la.
- Exemplos: as Respostas Esperadas e Respostas Erradas. Escolha Resposta certa ou Resposta errada no seletor, digite o valor (Adicionar exemplo…) e Adicionar. Polegar para cima e para baixo no resultado também adicionam exemplos aqui.
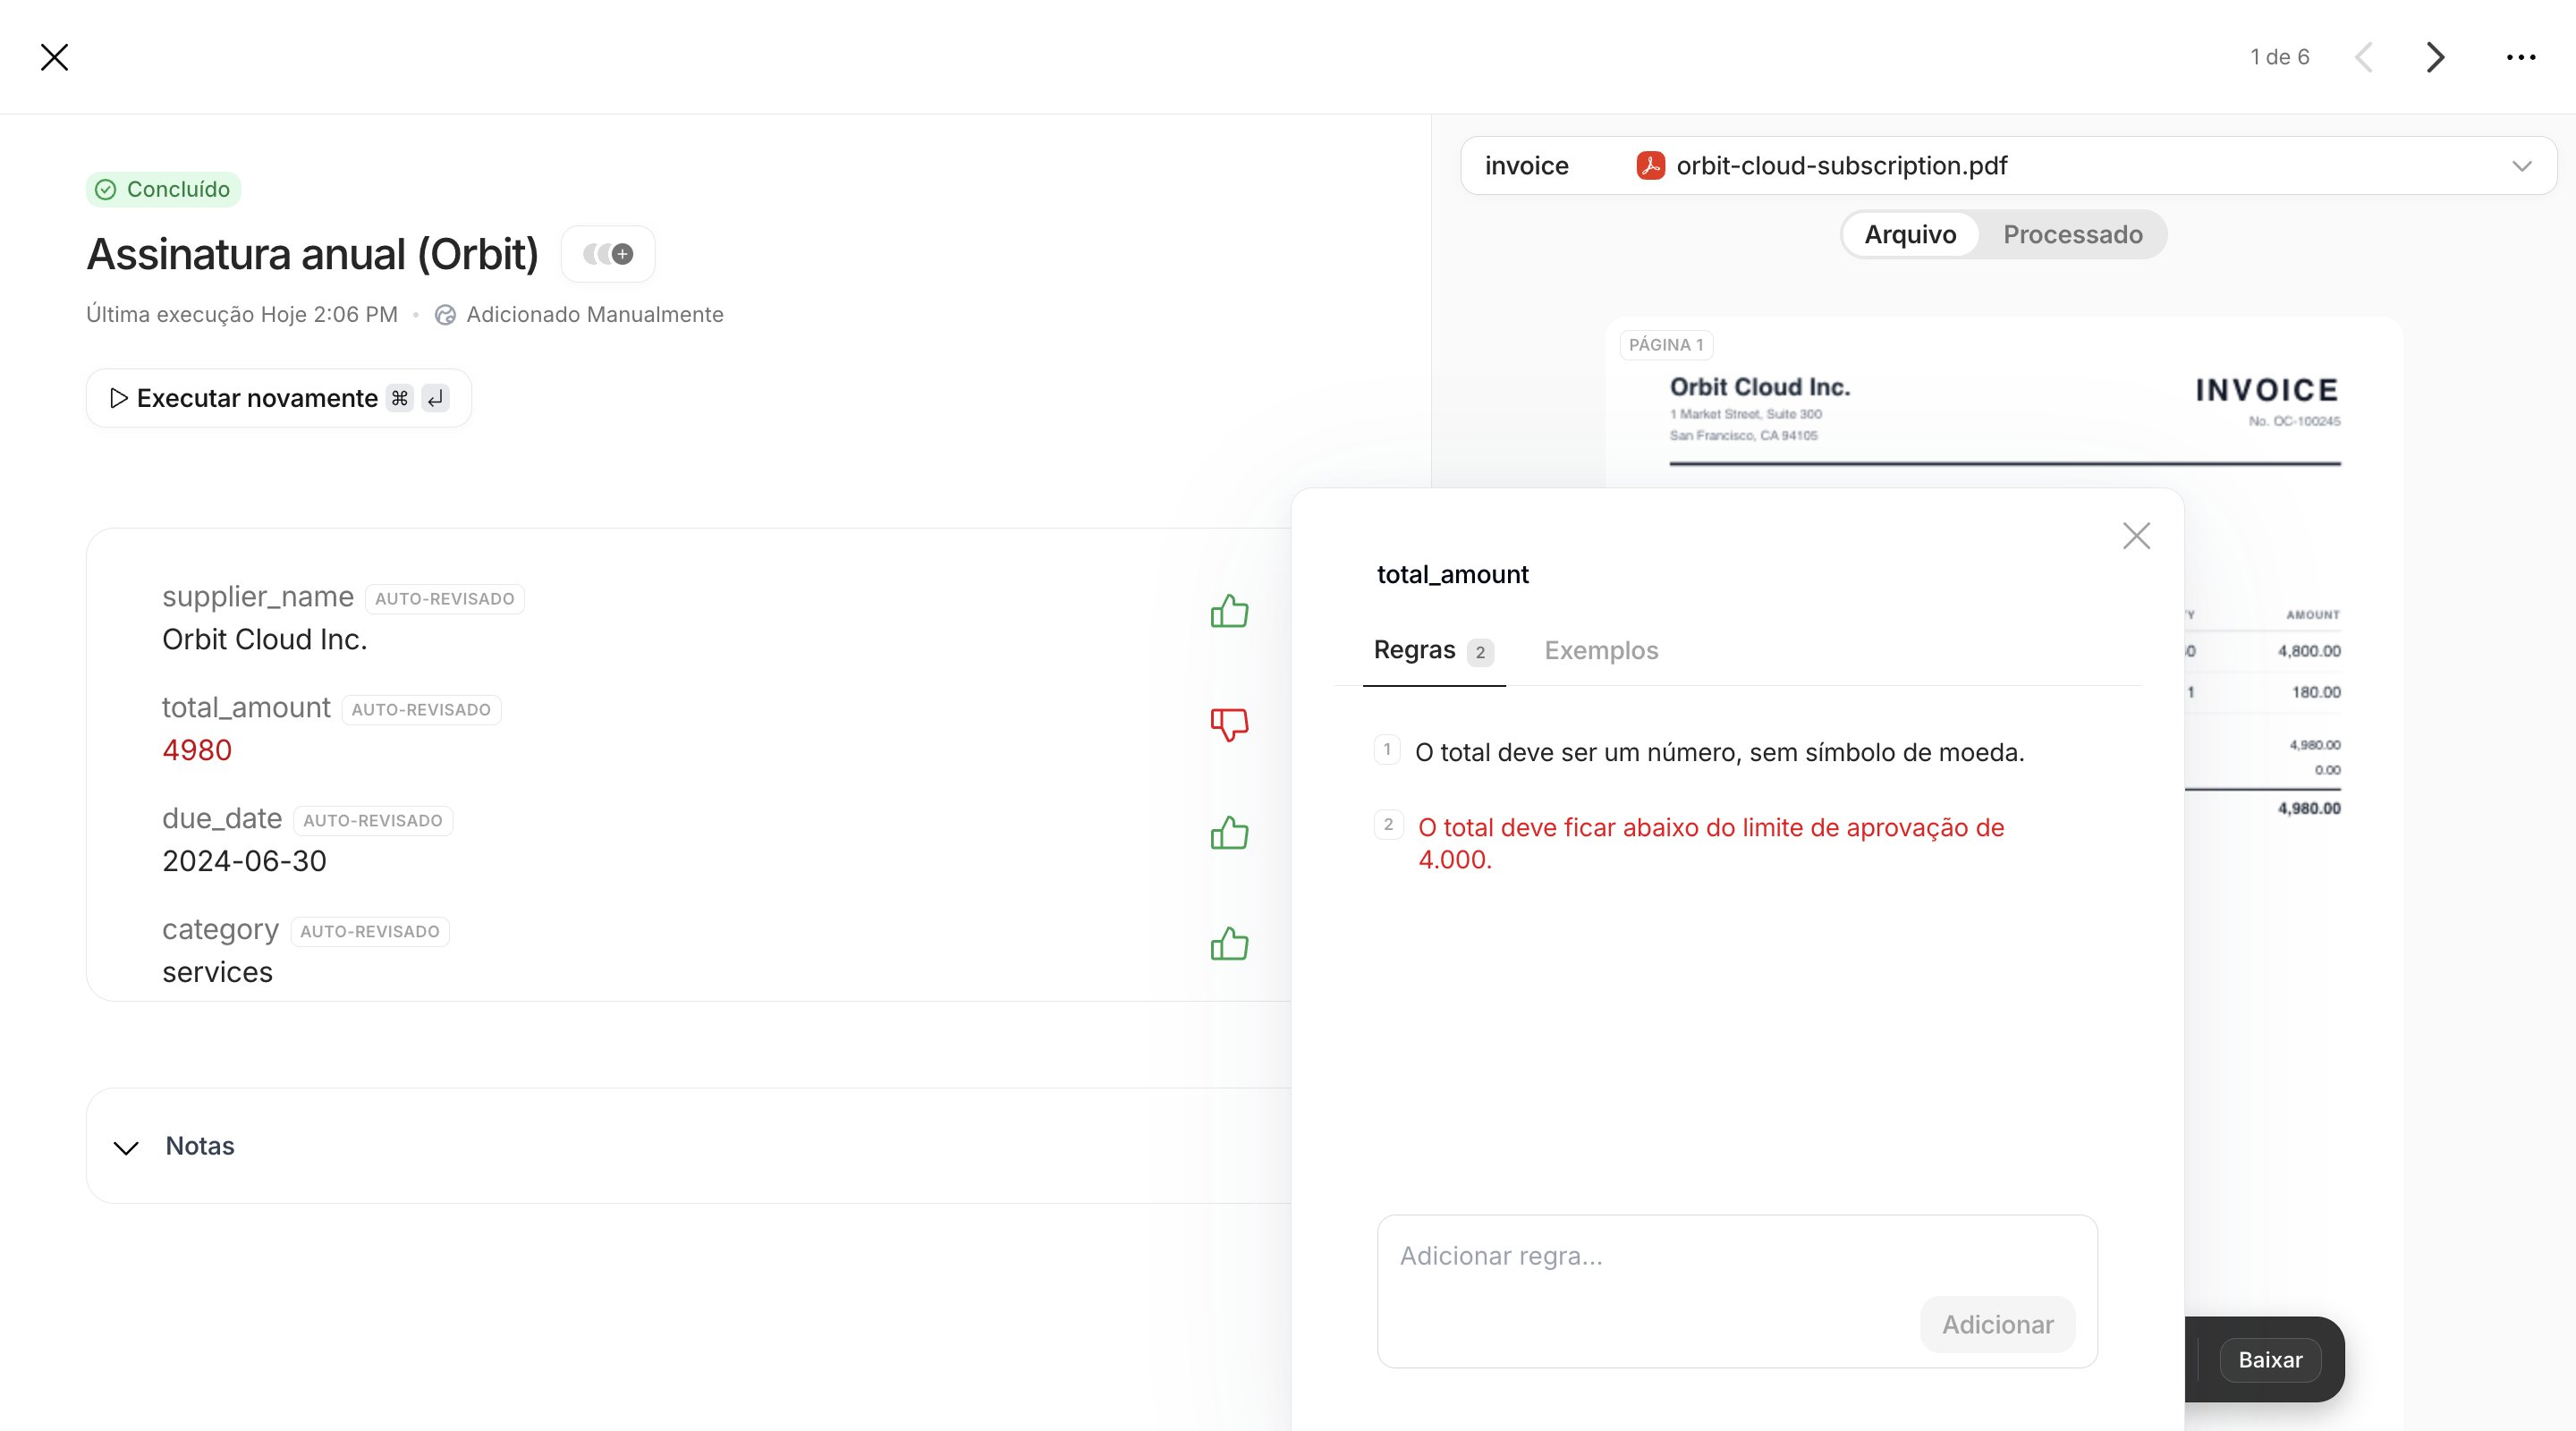
Regras e exemplos pertencem a um Caso de Teste. Não existe conjunto de regras do Canvas inteiro: uma regra que você quer em toda nota fiscal precisa ser adicionada a cada Caso de Teste, e um Caso de Teste novo começa sem nenhuma.
Respostas Esperadas e Erradas
Uma Resposta Esperada é um valor certo para este atributo neste Caso de Teste; uma Resposta Errada é um valor que foi produzido uma vez e está errado. Elas vêm de três lugares:- os seus polegares para cima (Esperada) e para baixo (Errada) em um resultado;
- uma tarefa da Workstation transformada em Caso de Teste: valores não tocados viram Esperadas, valores editados viram Errada (o original) e Esperada (a correção);
- a aba Exemplos, onde você as digita.
category da nota limpa, Office supplies e office-supplies podem ambas estar certas. A comparação ignora maiúsculas e minúsculas e, em listas, a ordem, então ["USD", "EUR"] coincide com ["eur", "usd"].
Como uma execução é validada
Quando uma execução termina, o Tela valida cada atributo do Formato de Saída antes de você ver:1
Correspondência exata com os exemplos
Um valor igual a uma Resposta Esperada é Bom (Corresponde exatamente a uma boa resposta). Um valor igual a uma Resposta Errada é Ruim (Corresponde exatamente a uma resposta errada).
2
Sem correspondência, com exemplos, sem regras
Quando o atributo tem Respostas Esperadas, o valor não coincide com nenhuma e não há regras, o valor é Ruim (Não corresponde às respostas esperadas).
due_date = 2024-01-05 quando a única Resposta Esperada é 2024-05-01 reprova aqui.3
Regras
Caso contrário, quando o atributo tem regras, um juiz de IA recebe o atributo, o valor e todas as regras de uma vez e devolve Bom ou Ruim com um raciocínio e uma confiança. Abaixo de 50% de confiança o veredito é inconclusivo e o atributo fica pendente para você.
4
Nada se aplica
Um valor vazio sem exemplos é sinalizado como Atributo está vazio. Qualquer outro valor sem exemplos e sem regras fica para você revisar.
Escolhendo entre exemplos e regras
Para o caso Não é nota fiscal, o
total_amount certo é vazio. Marque o valor vazio como Bom para que um resultado vazio seja uma Resposta Esperada, e adicione a regra Deve ser vazio, este documento não é nota fiscal para pegar um total inventado com uma explicação.
Métricas
O card de resumo mostra as métricas da versão que você está vendo, calculadas a partir da última execução de cada Caso de Teste naquela versão. Filtros na tabela (categorias, usuário, data, status) restringem as métricas às linhas que correspondem.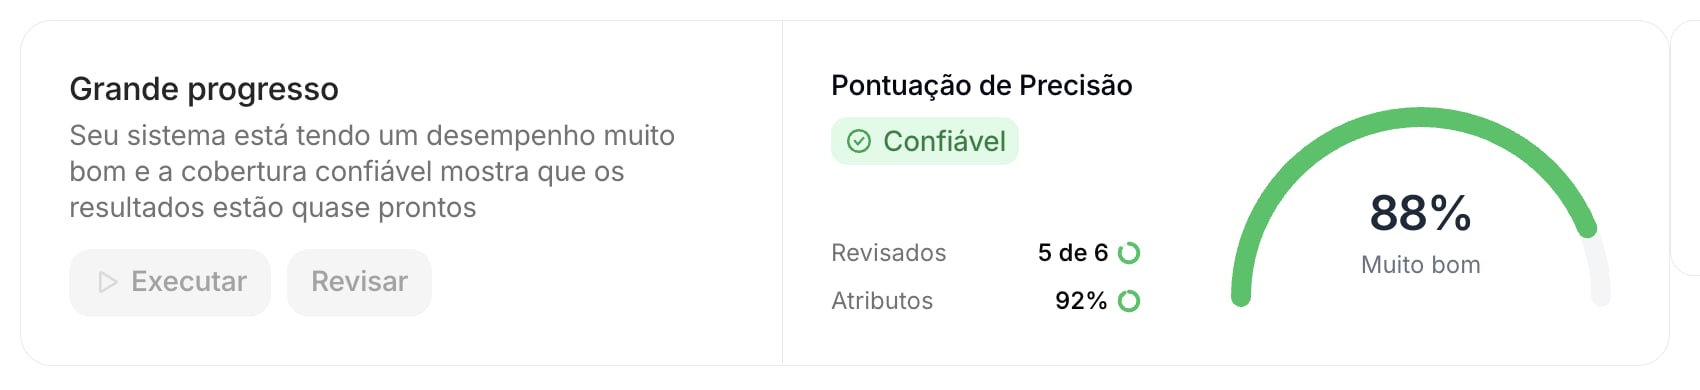
Leia as três juntas. Uma Pontuação de Precisão de 100% com Baixa cobertura quer dizer que você revisou poucos atributos e eles estavam certos; diz pouco sobre o resto. O título do card muda conforme a combinação das duas, de Comece a revisar a Continue revisando até Parabéns, seu sistema está ótimo!, e o arco em volta da pontuação fica cinza até a cobertura chegar a 40%.
Por Caso de Teste, a coluna Pontuação mostra a parcela de atributos marcados como Bom na última execução, e passar o mouse sobre o nome mostra as contagens de atributos positivos, negativos e pendentes. Um Caso de Teste cuja execução é mais antiga que a versão que você está vendo não mostra pontuação.
Atributos pendentes reduzem a Pontuação de Precisão de um Caso de Teste parcialmente revisado: quatro atributos, dois Bom e dois pendentes, dão 50%. Termine a revisão, ou use Marcar como revisado, antes de ler o número como medida de qualidade.
Em Agentes
Casos de teste de Agente mostram a mesma Pontuação de Precisão, Revisados e Atributos. Os vereditos vêm dos seus polegares e do avaliador, que julga o resultado inteiro contra as Regras do caso de teste e o prompt global de Configurar avaliador, e Critérios agrupa atributos para calcular precisões separadas. Veja Rodando todos.Em Workflows
Os atributos contados são os dos Formatos de Saída das etapas de IA do Workflow, agrupados por etapa. Etapas sem Formato de Saída não acrescentam nada às métricas. Veja Nos Casos de Teste.Pela API
Cada Caso de Teste devolvido porGET /test-case carrega seus answers (um objeto por atributo, com arrays good e bad) e, com includeGenerations=true, suas execuções com attributeFeedback e validations. Regras são adicionadas com POST /test-case/{id}/validation-rules/{attributeKey} e um corpo { "description": "..." }, e removidas com DELETE /test-case/{id}/validation-rules/{attributeKey}/{ruleId}.
Os endpoints de validation-rules e os de feedback de generation ainda não fazem parte da referência de API publicada. O formato deles vem da aplicação e pode mudar.